
De Wedstrijd
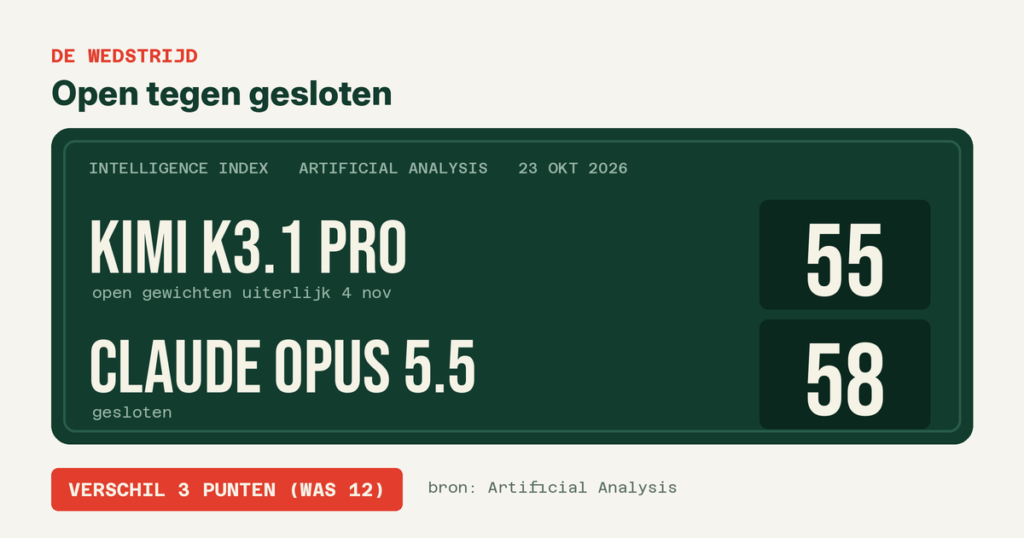
Moonshot AI bracht op 23 oktober Kimi K3.1 Pro uit, een groot taalmodel waarvan de gewichten uiterlijk 4 november vrijkomen. Volgens de onafhankelijke meting van Artificial Analysis staat het model direct op plek 4 van de ranglijst, achter drie gesloten modellen.
Zodra de gewichten vrij zijn, is het volgens Artificial Analysis het sterkste open model op die ranglijst. Hieronder de voorbeschouwing, de uitslag, wat de cijfers wel en niet zeggen, en wat je er als organisatie mee doet.
In het kort
- Kimi K3.1 Pro scoort 55 op de Artificial Analysis Intelligence Index. De koploper, Claude Opus 5.5, scoort 58.
- Als de gewichten vrij zijn, krimpt het gat tussen het beste open en het beste gesloten model van 12 naar 3 punten.
- De API kost $2 per miljoen inputtokens en $10 per miljoen outputtokens, een derde minder dan Kimi K3.
- Voor Europese organisaties is de vraag niet alleen hoe goed het is, maar ook waar je het draait.
Wat stond er op het spel?
De vraag was of een open model het gat met de gesloten top van OpenAI, Anthropic en Google zou kunnen dichten.
De vorige versie, Kimi K3, kwam in juli 2026 uit (Kimi Forum, 22 juli 2026) en scoorde 44 op de index. Vorige week zette Meta Muse Spark Open met open gewichten neer, maar dat model haalde de absolute top niet. Moonshot is volgens Bloomberg (23 oktober 2026) een bedrijf uit Beijing met een waardering van $50 miljard.
Wat is de uitslag?
Kimi K3.1 Pro wint vooral op agentwerk: taken van meerdere stappen in een terminal of in SaaS-tools.
Onafhankelijk gemeten
Volgens Artificial Analysis (23 oktober 2026):
| Meting | Kimi K3 | Kimi K3.1 Pro | Ter vergelijking |
|---|---|---|---|
| Intelligence Index | 44 | 55 | Claude Opus 5.5: 58 |
| GDPval-AA (kenniswerk, Elo) | 1.534 | 1.846 | Claude Opus 5.5: 1.866 |
| Terminal-Bench 4.0 | 13% | 67% | Claude Sonnet 5.5: 64% |
| AutomationBench-AA (SaaS-workflows) | 58% | 73% | |
| Hallucinatiegraad (AA-Omniscience) | 53% | 44% | lager is beter |
| Kosten per index-taak | ongeveer gelijk | $1,98 |
Volgens Moonshot zelf
Op de eigen techblog van Kimi (23 oktober 2026) noemt Moonshot 65,7% op Terminal-Bench 4.0, tegen 58,2% voor GPT-6 Astra en 66,4% voor Claude Opus 5.5. Het model heeft 2,8 biljoen parameters waarvan 104 miljard per stap actief, een contextvenster van 1 miljoen tokens, en leest tekst en beeld. Er is ook een Highspeed-variant die volgens Moonshot 2 tot 3 keer sneller is.
Een open model op 3 punten van de top betekent dat je een serieuze terugvaloptie hebt. Het betekent nog niet dat je moet overstappen.
Wat zeggen de cijfers wel en niet?
De sprong is echt en onafhankelijk bevestigd, maar de cijfers zeggen weinig over jouw eigen taken en niets over waar je data heen gaat.
- Maker en meting verschillen. Moonshot meldt 65,7% op Terminal-Bench 4.0 en zet zichzelf net achter Opus 5.5. Artificial Analysis meet 67% en noemt dat de hoogste score van alle modellen. Verschillende testopstellingen geven verschillende uitkomsten, dus een plek 1 of 2 op één benchmark is geen hard verschil.
- Kennisvragen blijven achter. Op Humanity’s Last Exam gaat het model van 47% naar 52%, een veel kleinere stap dan bij agenttaken (Artificial Analysis, 23 oktober 2026).
- Nog steeds veel fouten. Een hallucinatiegraad van 44% is beter dan 53%, maar betekent dat het model bij vragen die het niet weet nog vaak toch een antwoord verzint.
- “Open” is nog een belofte. Op dit moment draai je het model alleen via Moonshot. De gewichten komen volgens Moonshot uiterlijk 4 november.
Wat betekent dit voor jouw bedrijf?
Gebruik deze release om je afhankelijkheid van één leverancier te verkleinen, niet om halsoverkop te wisselen.
- Test op je eigen werk. Leg 20 echte taken uit je organisatie naast je huidige model en meet kwaliteit en kosten. Een ranglijst vervangt die test niet, zoals we eerder schreven over AI model drift in productie.
- Kijk waar de data heen gaat. Via de API van Moonshot werk je met een Chinese aanbieder. Moonshot biedt API-klanten Zero Data Retention aan, maar leg dit naast je eigen AI-beleid en je verwerkersafspraken voordat er klantdata in gaat.
- Wacht op de gewichten als je data in Europa wilt houden. Met open gewichten kun je het model later via een andere aanbieder of op eigen infrastructuur draaien. Reken wel op zware hardware: een model van deze omvang draai je niet op een gewone server.
- Werk je exitplan bij. Een sterk open model is precies de terugvaloptie die in een goed plan tegen AI vendor lock-in hoort.
- Reken per taak, niet per token. Kimi K3.1 Pro gebruikt meer tokens per taak dan zijn voorganger, maar heeft lagere tarieven. Alleen de kosten per taak vertellen je of het goedkoper uitpakt.
Wil je weten welke processen een ander of goedkoper model echt iets opleveren, kijk dan bij onze aanpak voor AI-automatisering en ROI.
Wat is de eindstand?
Sterk en goedkoop, maar voor de meeste Nederlandse organisaties nog niet direct inzetbaar.
| Onderdeel | Onze inschatting |
|---|---|
| Prestatie | 8: plek 4 wereldwijd, sterkst op agenttaken |
| Prijs | 8: $1,98 per index-taak, tarieven een derde lager |
| Inzetbaarheid nu | 5: alleen via Moonshot tot de gewichten vrij zijn |
Wie moet hier nu iets mee: teams die agents of codeerwerk draaien en een tweede leverancier zoeken. De rest kan rustig 4 november afwachten.
Veelgestelde vragen
Kimi K3.1 Pro is een groot taalmodel van het Chinese Moonshot AI, uitgebracht op 23 oktober 2026, met een contextvenster van 1 miljoen tokens. Het werkt nu via Kimi.ai, Kimi Work, Kimi Code en de Kimi API, en de open gewichten komen volgens Moonshot uiterlijk 4 november 2026 vrij.
Gemiddeld niet: op de Intelligence Index van Artificial Analysis scoort Kimi K3.1 Pro 55, tegen 58 voor Claude Opus 5.5. Op een aantal agenttaken, zoals Terminal-Bench 4.0, scoort het wel even hoog of hoger.
Via de API van Moonshot kost Kimi K3.1 Pro 2 dollar per miljoen inputtokens en 10 dollar per miljoen outputtokens. Artificial Analysis rekende 1,98 dollar per taak in hun testset.
Weet binnen twee weken welke drie processen het meeste opleveren, en met welk model.
Bronnen: Artificial Analysis, 23 oktober 2026, Kimi techblog, 23 oktober 2026, Bloomberg, 23 oktober 2026, Kimi Forum, aankondigingen.